 我的书签
 添加书签
 移除书签
anydoc 的定位很清晰:一个输入模型 + 一个输出序列化器 = 所有格式行为一致。不管是 2003 年的老 .doc 还是昨天刚存的 .pptx,标题层级、嵌套列表、合并单元格、脚注,出来的 Markdown 格式完全相同。这意味着你不用再为”这个格式表头怎么丢了””那个格式列表缩进不对”这类问题折腾。
核心参数一览:
语言:RustStar:19,836协议:MIT支持格式:Word(.doc/.docx/.docm)、PowerPoint(.ppt/.pptx/.pps/.pot/.pptm/.ppsx/.ppsm)、Excel(.xls/.xlsx/.xlsm/.xlsb)、OpenDocument(.odt/.ods/.odp)、RTF、EPUB、CSV、PDF
对个人开发者:写博客、整理笔记、把老板发的 Word 方案转成 Markdown 存 Obsidian,一条命令的事。不用再开 Word 复制粘贴了。
对团队 / 企业:知识库入库(比如 MaxKB)、RAG 管道预处理、合同/标书结构化提取——只要涉及”多种文档格式 → 统一文本”,anydoc 都能当标准转换层。14 种格式全覆盖意味着不用再维护”这个格式用 A 工具、那个格式用 B 工具”的分支逻辑。
速度带来的可能性:4.4 毫秒的中位耗时意味着它可以塞进实时链路。用户上传文档 → anydoc 转 Markdown → 送进 LLM / 向量库,整条链路可以在亚秒级完成。
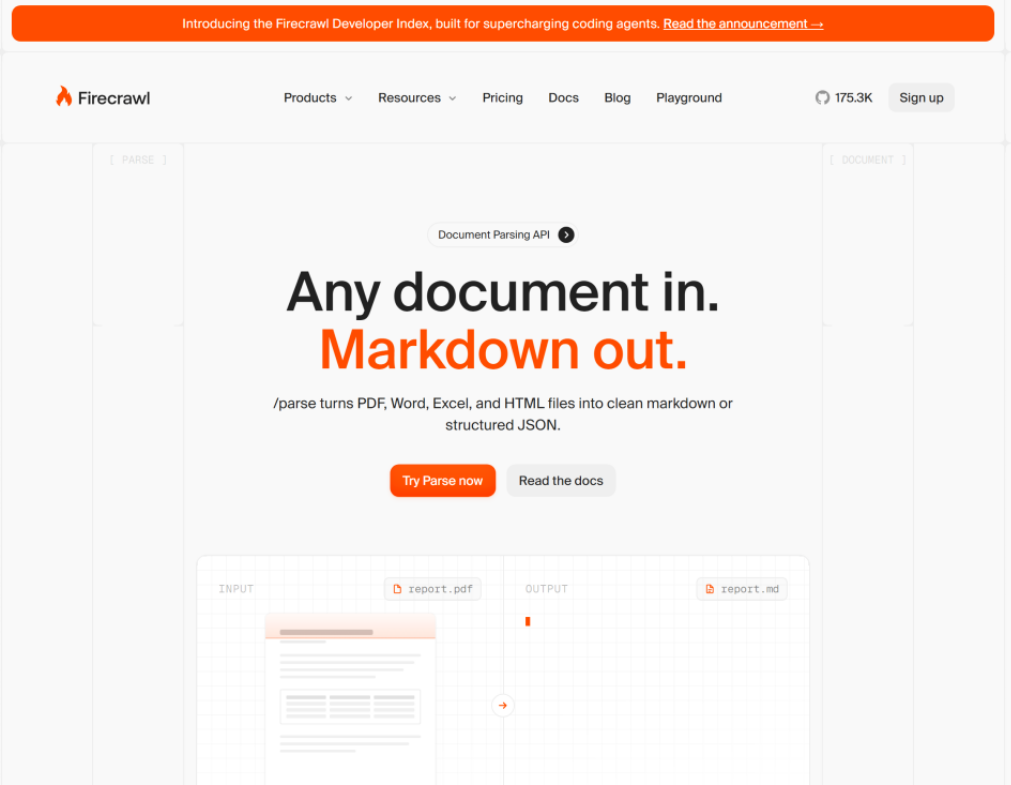
扫描件也不怕:本地搞不定的扫描 PDF,一行参数切到 Firecrawl Parse 托管 OCR,输出还是同款 Markdown,代码不用改。
下次再收到一堆 .docx/.pptx/.pdf,试试 npx @firecrawl/anydoc,也许就回不去了。
